검색 벤치 — 18에서 23으로
본편 「GraphRAG 검색 원리」의 짝꿍 — 실제 24문항을 돌려 정답률을 어떻게 끌어올렸는지, 그리고 정직하게 못 잡은 1개까지.
- "정답·상위 5위·속도"가 정확히 무슨 뜻인지
- 같은 질문을 기본 검색 vs GraphRAG로 돌리면 얼마나 다른지 (0 · 7 · 23)
- 18을 23으로 올린 3단계 — 그리고 점수 부풀리기를 안 했다는 증거
- 순위도 없는 기본 검색이 그래도 꽤 먹히는 이유 (우리 볼트 구조)
먼저 — 용어 4개만
표와 막대를 보기 전에, 딱 4개만 알면 됩니다. 어렵지 않아요.
질문마다 "이 문서가 나와야 한다"고 미리 정해둔 핵심 문서입니다. 대부분 주제별 목차(MOC) 문서예요. 검색 결과에 이게 뜨면 정답.
검색 결과 목록의 맨 위 5개 안에 정답이 들어왔는가. 사람은 보통 위 5개만 보니까, "위 5개 안에 정답이 있나"가 실질 성공 기준입니다. 23/24는 24문항 중 23개에서 정답이 상위 5위 안에 들어왔다는 뜻.
"위 5개 안에 있나(hit@5)"만으론 그게 1위인지 5위인지 구분이 안 되죠. MRR은 정답이 평균 몇 등으로 나오는지를 0~1 점수로 압축한 거예요 — 1등이면 1점, 2등 0.5점, 4등 0.25점… 식. 우리 점수 0.81 = 정답이 평균 1.2등쯤(거의 1등)에 나온다는 뜻입니다.
질문 하나에 답을 찾기까지 걸린 시간(밀리초, 1000ms=1초). 같은 질문을 3번 돌려 가운데값(중앙값)을 씁니다.
어떻게 쟀나 — 24문항 · 3회 · 채점
"23개 맞혔다"가 어디서 나온 숫자인지, 측정 과정을 그대로 공개합니다. 끼워맞춤이 없다는 걸 보이려면 방법부터 투명해야 하니까요.
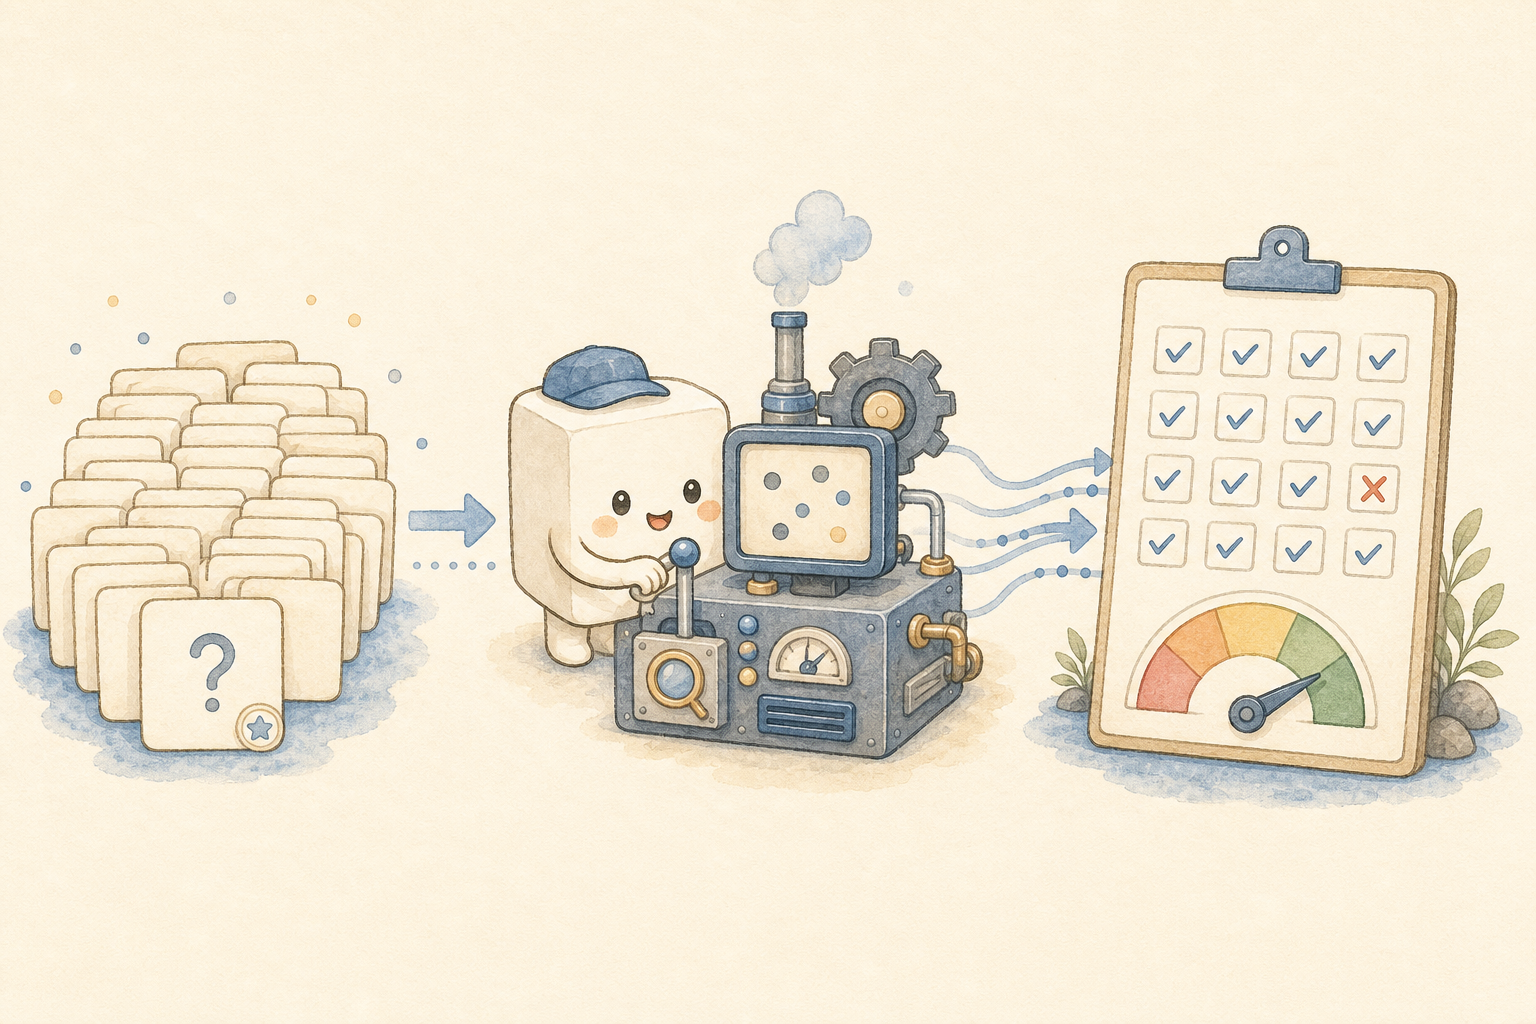
우리가 실제로 볼트에서 찾을 법한 질문 24개를 뽑았습니다. 쉬운 것(단어 하나, 예 "MCP"·"GraphRAG")부터 막연한 것(개념·관계를 묻는, 예 "RAG와 GraphRAG의 차이"·"내 지식에서 핵심 주제 3가지의 연결")까지 난이도를 섞었어요. 질문마다 "이게 정답 문서"를 미리 정해뒀습니다(대부분 그 주제의 목차=MOC 문서).
테스트용 흉내가 아니라 실제로 돌아가는 검색 서버에 같은 질문을 넣습니다. 속도는 3번 돌려 가운데값을 써요(한 번 튄 값에 안 휘둘리려고). 정확도(순위)는 같은 질문이면 매번 같게 나오니 한 번이면 충분합니다.
결과를 받으면 두 가지로 채점합니다 — 상위 5위 안에 정답이 들었나(hit@5) + 정답이 평균 몇 등인가(MRR). 하나는 "성공/실패", 하나는 "얼마나 위냐". 둘을 같이 봐야 "간신히 5위로 맞혔다"인지 "1위로 시원하게 맞혔다"인지가 구분됩니다.
같은 24문항 — 0 · 7 · 23
똑같은 24개 질문을 두 방식으로 돌렸습니다. 막대는 "정답을 상위 5위 안에 올린 개수"입니다.
옵시디언 기본 검색은 'MCP'라는 글자가 든 곳을 전부 찾아주지만 — "어느 게 더 관련 있나"를 판단하지 않습니다(순위가 없음). 그래서 흔한 단어일수록 정답이 묻혀요. 실제로 "MCP" 검색 = 1,279개 결과가 나오는데 정답은 357위에 묻혔습니다. '찾아지냐'는 되지만 '정답이 위로 오느냐'가 안 되는 거죠.
경로별로 — 뭘 어떻게 쟀나
"기본 검색 0, GraphRAG 23"이 어떻게 갈렸는지 — 두 경로가 같은 질문에 각각 무슨 일을 하는지를 실제 측정값으로 해부합니다.
같은 24질문을 옵시디언 기본 검색에 넣되, 두 가지로 측정했습니다:
- 그냥(raw) — 검색이 준 순서 그대로. 순위 판단이 없어 정답이 한참 밑에. → 0/24
- 구조 가중(struct) — 결과를 "파일명에 질문어가 들었나 + 목차(MOC) 문서인가"로 다시 줄 세움. → 7/24
| 질문 | 검색 결과 수 | 그냥(raw) 순위 | 구조 가중 순위 |
|---|---|---|---|
| MCP | 1,279개 | 357위 ✗ | 1위 ✓ |
| 김재경 | 812개 | 745위 ✗ | 1위 ✓ |
| GraphRAG | 786개 | 164위 ✗ | 1위 ✓ |
| 얼룩소 아카이브 | 674개 | 78위 ✗ | 1위 ✓ |
| 프롬프트 엔지니어링 | 550개 | 30위 ✗ | 1위 ✓ |
→ 정답은 결과 안에 있긴 한데 수백~천 개 중에 묻혀 있어요(그냥 = 전부 5위 밖 = 0/24). 파일명·목차 구조로 다시 줄 세우면 7개는 1위로 올라옵니다 — 우리 볼트의 작명·MOC 규율이 '순위'를 대신 메운 것(뒷장 "그래도 먹히는 이유"). 나머지 17개는 구조로도 못 잡아요 — "RAG와 GraphRAG의 차이"처럼 의미·관계를 묻는 질문이라, 바로 여기서 GraphRAG가 필요해집니다.
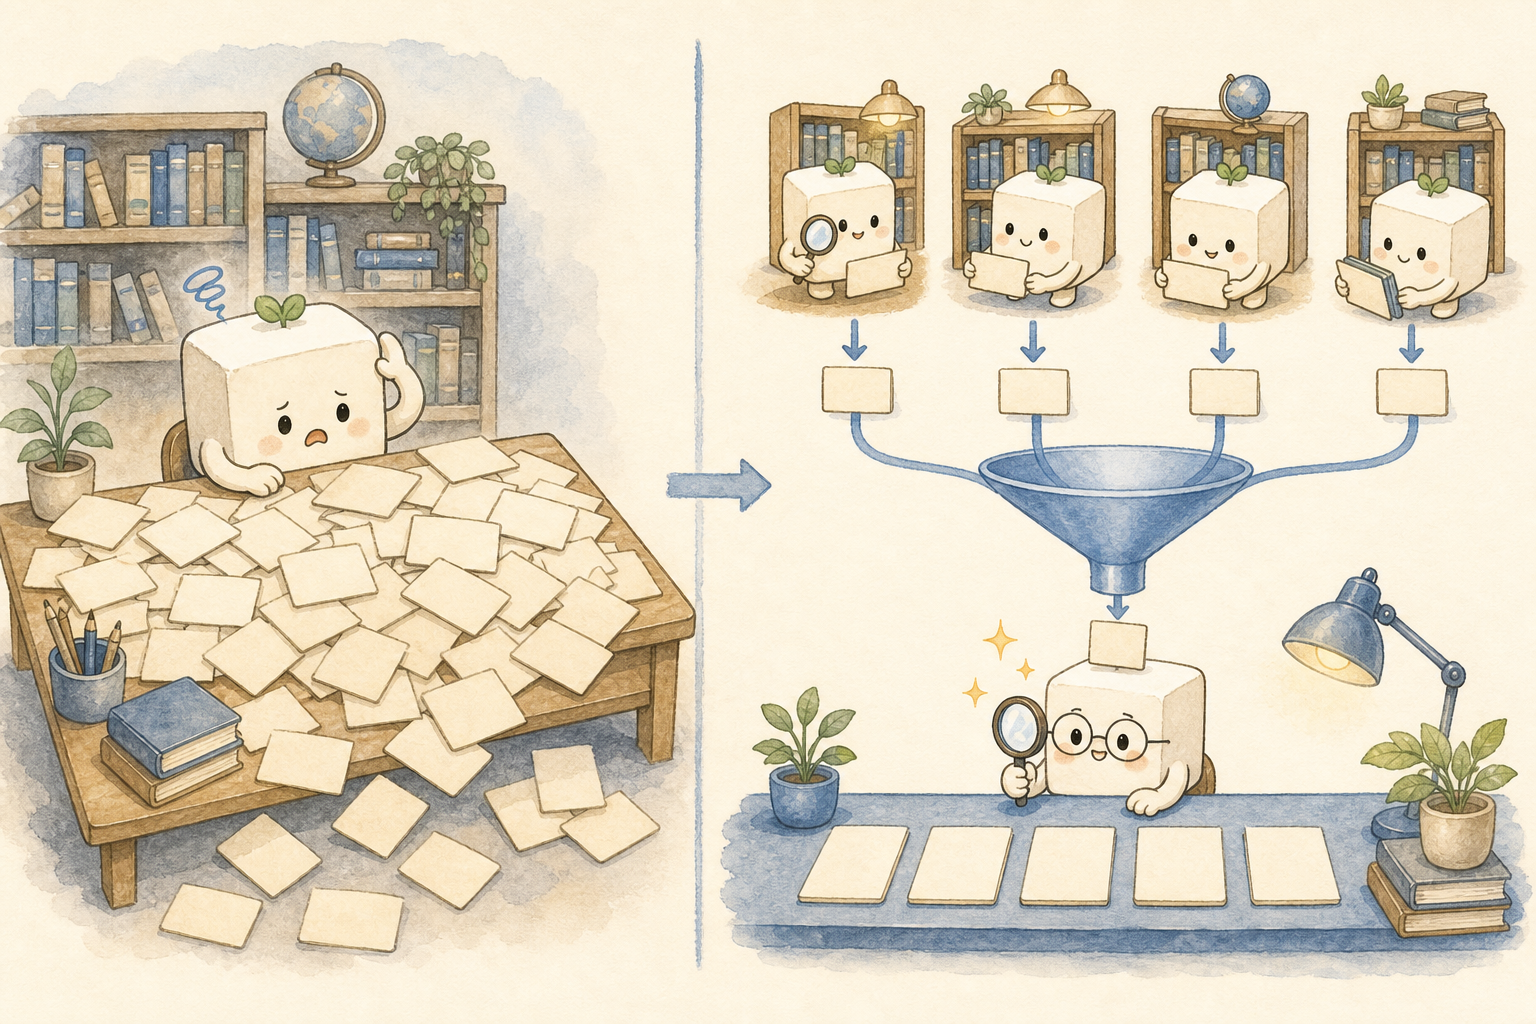
GraphRAG는 한 질문을 4개 채널이 동시에 검색합니다. "프롬프트 엔지니어링" 질문에 각 채널이 실제로 올린 결과예요(라이브 trace):
뜻으로 — "옵시디언"(0.79)·"실험보고서"(0.78)·"Codex-CLI-가이드"(0.63). 단어가 안 겹쳐도 뜻이 가까운 걸 가져와요(가끔 엉뚱한 것도).
글자로 — "프롬프트엔지니어링"·"프롬프트-엔지니어링-핵심원칙"·"…-한계". 단어가 그대로 든 노트.
개념으로 — "컨텍스트-엔지니어링"(0.88)·"컨텍스트윈도우-하네스엔지니어링"(0.88). 연관된 개념 노트.
복잡한 질문을 작은 질문들로 쪼개 각각 검색(이 질문은 단순해서 비어 있음).
→ 네 채널 결과를 RRF로 공정하게 합산(여러 채널이 공통으로 올린 걸 위로) → 재정렬(검사원=cross-encoder)이 질문과 가장 잘 맞는 걸 다시 골라 → 최종 상위 5. 그래서 의미 채널이 잘못 올린 "옵시디언" 같은 잡음은 걸러지고, 단어·개념 채널이 받친 진짜 정답이 위로 옵니다.
18 → 23, 어떻게 올렸나
설정값(채널 가중치)만으로는 18이 천장이었습니다. 검색 엔진의 핵심 부품(의미 모델)을 더 똑똑한 것으로 교체하고, 벤치 정답 자체의 오류를 바로잡으니 23까지 올랐어요. 세 단계로:
더 똑똑한 의미 모델
의미를 좌표로 바꾸는 모델을 옛것(MiniLM)에서 한국어·다국어에 강한 새 모델 bge-m3로 교체하고 채널 합산 방식을 손봤습니다. 검색 자체가 18→20.
전혀 다른 48문항으로도 검증
"24문항에만 맞춘 꼼수 아니냐"를 막으려고, 겹치지 않는 48개 독립 질문으로도 측정했습니다 → 9 → 15 동반 상승, 하나도 안 깎임. 특정 문제집 답을 외운 게 아니라 전체 실력이 늘었다는 증거.
틀린 건 검색이 아니라 정답이었다
원래 '놓침' 6개 중 3개(Q07·Q08·Q21)는 검색이 더 나은 노트를 1위로 올렸는데 우리가 적어둔 정답이 좁았던 것. 정답 정의를 바로잡으니 23.
새 모델이 더 무거워서 속도는 조금 느려집니다(테스트 측정 약 0.15초 → 0.23초). 정확도(18→23)를 위해 속도를 조금 내준 셈 — 그래도 0.23초라 체감은 어렵습니다.
기본 검색은 왜 '그래도' 먹히나
순위도 없는 기본 검색이 24문항 중 7개나 잡는 건 도구가 좋아서가 아니라, 우리가 노트를 구조적으로 잘 정리해뒀기 때문입니다. 4가지 구조가 받쳐줘요 — 전부 실측.
노트 이름에 핵심 주제어를 그대로 넣는 규율(예: MCP-생태계-MOC·GraphRAG-Theory-MOC). 그래서 결과를 '파일명에 질문어가 든 것' 우선으로 다시 줄 세우면 정답이 위로 올라옵니다.
노트 윗부분에 영문/한글 별칭(aliases)과 태그를 달아둡니다. 영어로 검색해도 한글 노트가, 한글로 검색해도 영문 개념이 걸려요. ("MCP" 노트 별칭 = "Model Context Protocol" 등.)
주제마다 'MOC' 목차 노트를 둬 관련 문서를 모으고, 노트끼리 촘촘히 링크로 엮습니다. 그래서 "이 노트로 뭐가 연결됐나"를 즉시 답할 수 있어요 — 이건 기본 검색(CLI)이 GraphRAG보다 오히려 잘하는 영역입니다.
한 장 요약
무엇을 쟀나 — 같은 24개 질문에 정답이 상위 5위 안에 들어오는 비율. 사람이 실제로 보는 건 위 몇 개니까요.
왜 올랐나 — ① 의미 모델 교체(bge-m3) ② 별도 48문항 검증(과적합 차단) ③ 잘못 적은 정답 교정. 셋이 합쳐 23.
왜 믿나 — 끝까지 못 잡은 1개(Q09)를 끼워맞추지 않고 남겼습니다. 24가 아니라 정직한 23인 이유.
기본 검색과의 관계 — 우열이 아니라 용도. 정확히 알면 기본 검색, "그게 어디 있더라"는 GraphRAG.
근거 raw:
gr_goldfix_24q.json(개선 후 23/24·mrr 0.81) · broadval-48q(광범위 9→15) · 측정 = 라이브 서버 24문항×3회